 ← RetourAccueil du site
Le Coran et la loi de Zipf : chaque couche ajoutée l’éloigne de la constante
Aucune langue n'a été conçue par un comité. Pourtant, toutes obéissent à la même constante, qui sort d'un simple comptage : une loi naturelle du langage, que personne n'a décidée. J'ai mesuré le Coran à cette constante, sur huit transmissions. Le texte écrit, les lettres seules, la suit. Et chaque couche qu'on lui a ajoutée l'en éloigne.
Les quatre lois
Le linguiste George Zipf a décrit, dans la première moitié du XXᵉ siècle, des régularités que l'on retrouve dans toutes les langues mesurées :
- Rang × fréquence ≈ constante. Classés du plus fréquent au moins fréquent, les mots décroissent selon une droite de pente proche de 1 sur un graphique logarithmique.
- Les hapax. Environ la moitié des mots différents d'un texte n'y apparaissent qu'une seule fois.
- La brièveté. Plus un mot est employé, plus il est court.
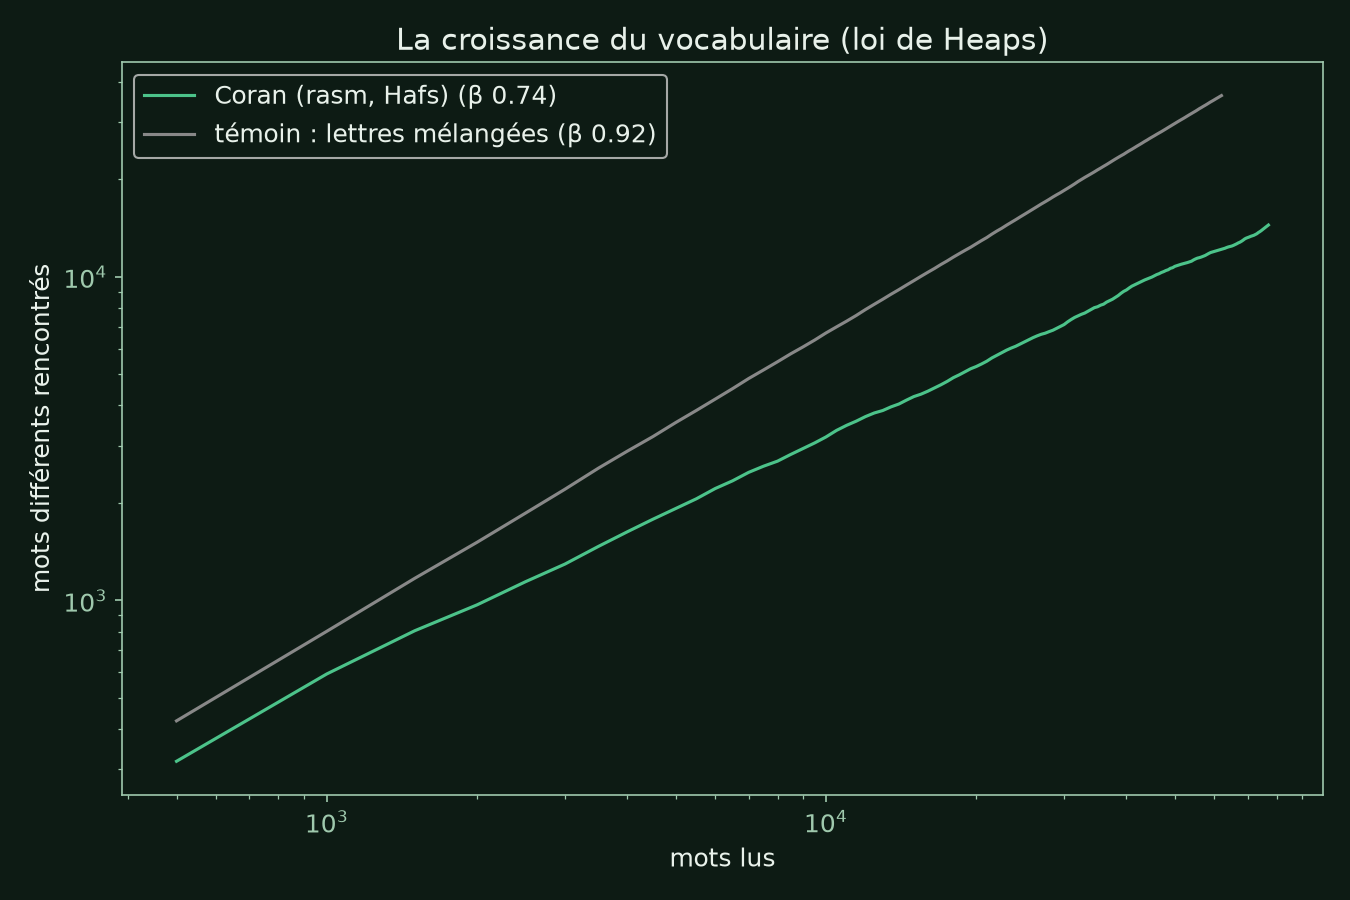
- La croissance du vocabulaire (loi de Heaps). Quand le texte double, son vocabulaire ne double pas : il croît selon un exposant compris, pour les langues, entre 0,4 et 0,8 environ.
Pourquoi un témoin
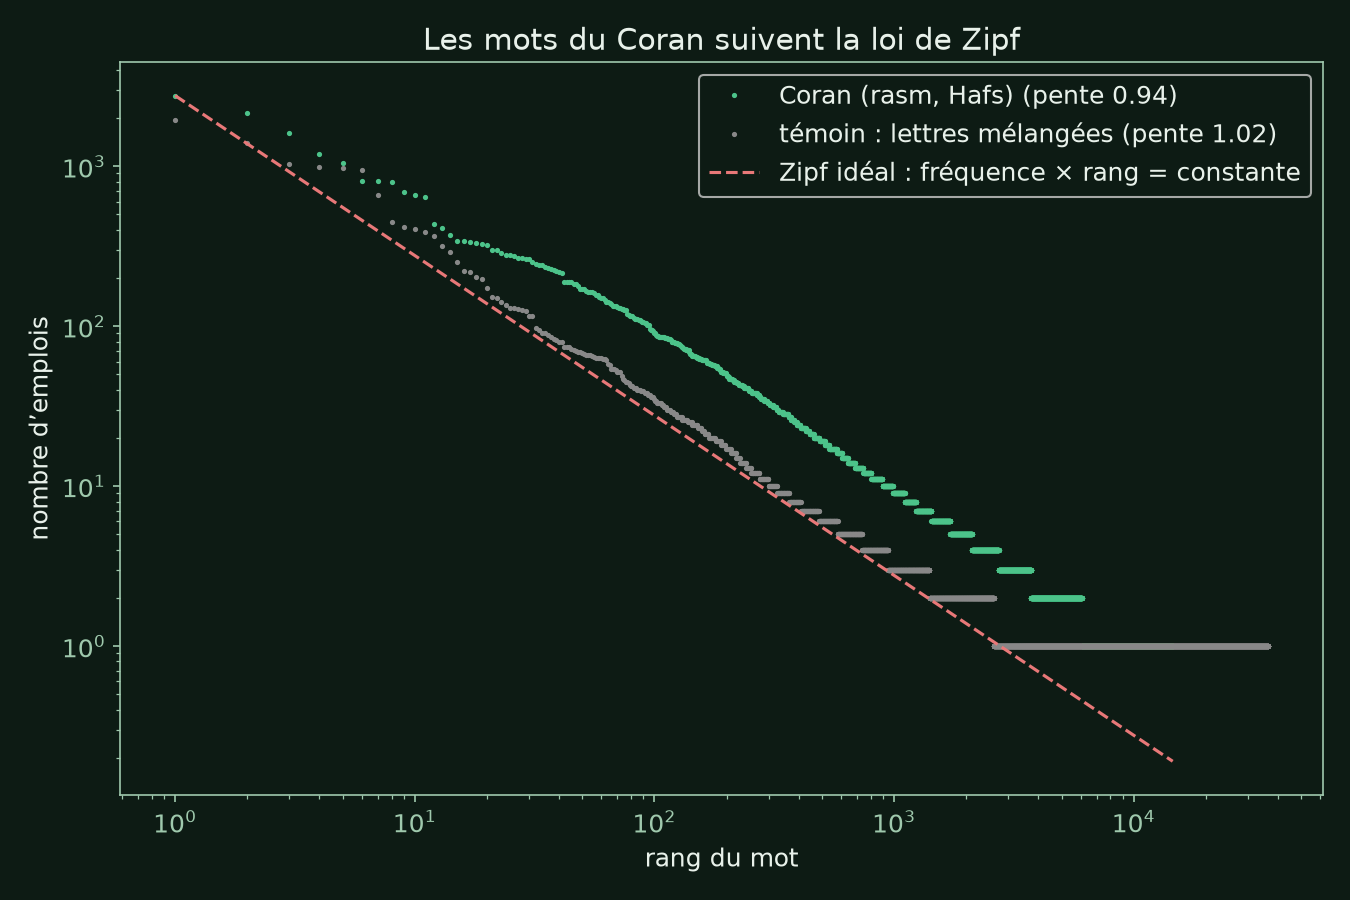
On sait depuis 1957 qu'un texte tapé au hasard, lettres et espaces, produit lui aussi une courbe proche de la première loi. La courbe seule ne prouve donc rien. J'ai fabriqué un témoin : les mêmes lettres et les mêmes espaces que le Coran, mélangés au hasard. Une langue doit passer les quatre tests ; le hasard, non.
Les résultats
| Loi | Mesure | Coran (rasm) | Témoin mélangé |
|---|---|---|---|
| mots · mots différents | 77 430 · 14 545 | 62 308 · 36 458 | |
| 1. Zipf | pente (idéal : 1), rangs 1 à 1 000 | 0,94 (R² 0,993) | 1,02 (R² 0,995) |
| 2. Hapax | part des mots employés une fois | 58,3 % | 92,8 % |
| 3. Brièveté | longueur des 100 mots les plus fréquents / des hapax | 3,4 / 5,5 lettres | 1,7 / 8,0 lettres |
| 4. Heaps | exposant de croissance du vocabulaire | 0,74 | 0,92 |
Le Coran passe les quatre tests. Le témoin passe le premier, comme prévu, et échoue aux trois autres : presque tous ses mots sont uniques, ses mots les plus fréquents n'ont qu'une lettre, et son vocabulaire ne cesse jamais de croître.
Le sommet de la liste
| Rang | Mot | Emplois |
|---|---|---|
| 1 | من | 2 763 |
| 2 | الله | 2 155 |
| 3 | ان | 1 605 |
| 4 | في | 1 185 |
| 5 | ما | 1 046 |
| 6 | لا | 812 |
| 7 | الذين | 811 |
| 8 | الا | 797 |
| 9 | علي | 686 |
| 10 | ولا | 658 |
Le résultat central : les couches ajoutées éloignent le texte de la constante
J'ai refait la mesure sur les huit transmissions disponibles (Hafs, Shou'ba, Warsh, Qâloûn, al-Bazzî, Qounboul, ad-Doûrî, as-Soûsî). Sur le rasm, les huit donnent la même pente au millième près : de 0,943 à 0,945. Puis j'ai remis, une à une, les couches ajoutées au texte.
| Couche | Hafs : pente | Warsh : pente |
|---|---|---|
| squelette sans points | 0,940 | 0,940 |
| rasm écrit (lettres et points) | 0,944 | 0,945 |
| + voyelles internes seules | 0,936 | 0,928 |
| + voyelles finales seules (la grammaire) | 0,928 | 0,913 |
| texte vocalisé complet | 0,915 | 0,903 |
| témoin : voyelles tirées au hasard | 0,697 | 0,686 |
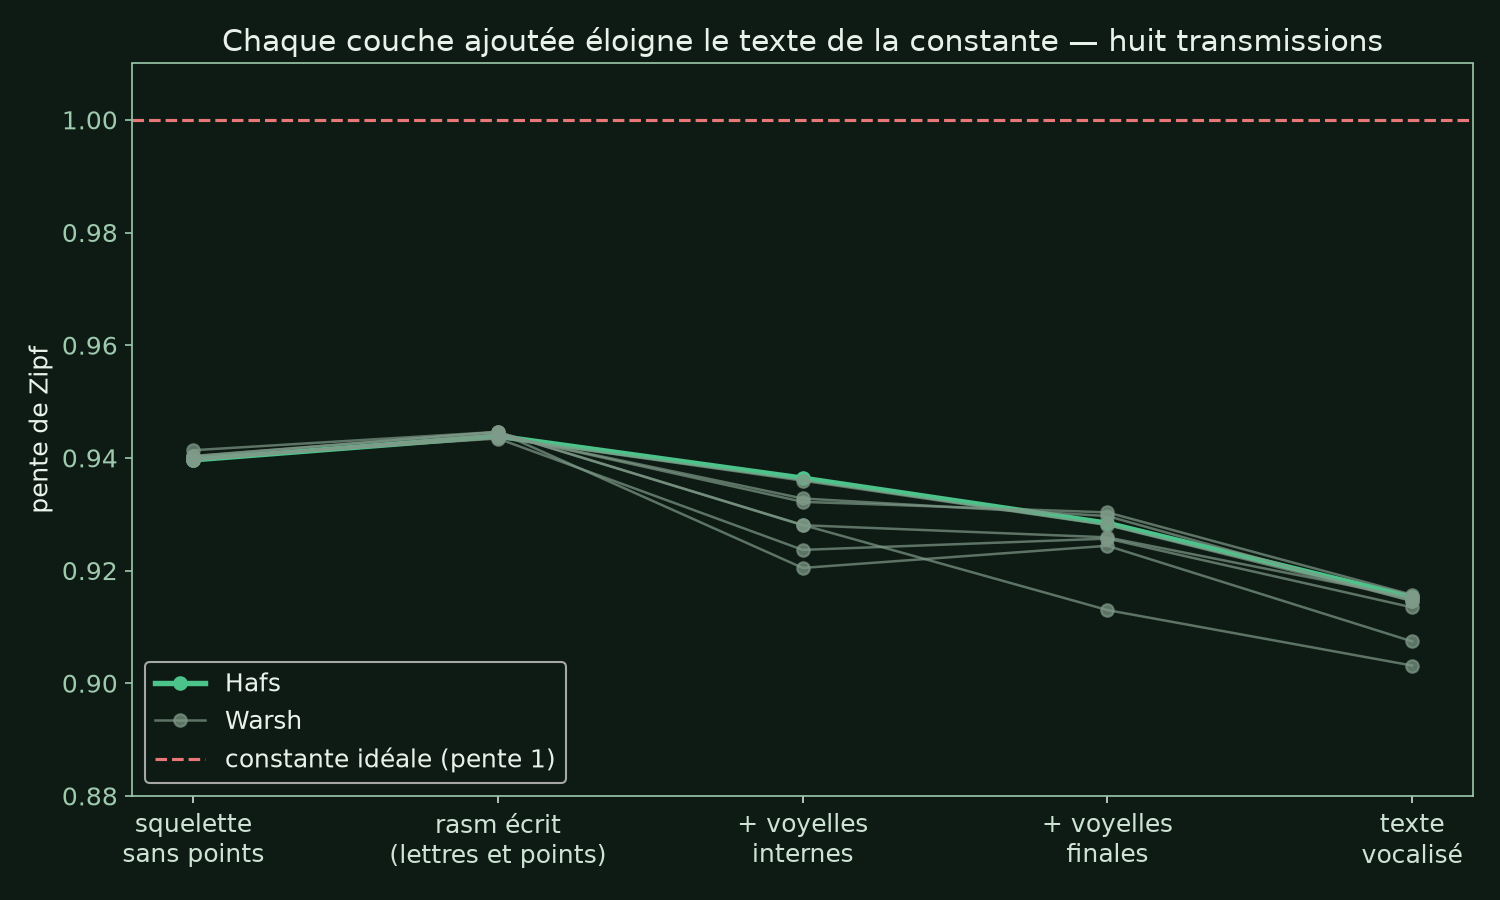
Le sommet est le rasm écrit. Chaque couche ajoutée éloigne le texte de la loi, dans les huit transmissions sans exception (de 0,94 à une valeur comprise entre 0,90 et 0,92). Ce sont les voyelles de fin de mot, celles qui fixent la fonction grammaticale, qui l'en éloignent le plus. Chez Warsh, c'est le cas même avec moins de formes nouvelles que les voyelles internes.
Une correspondance, à lire comme telle : 4:119, où le Shaytan dit وَلَءَامُرَنَّهُمۡ فَلَيُغَيِّرُنَّ خَلۡقَ ٱللَّهِ, « et je leur ordonnerai, alors ils dévieront la trajectoire de la controverse réunie d'Allah ». D'un côté, une constante que personne n'a ordonnée ; de l'autre, une couche ajoutée qui en fait dévier le texte.
Ce que cela montre
Une loi naturelle du langage, que personne n'a ordonnée, est respectée au plus près par le texte écrit, tel qu'il a été transmis. Les couches posées ensuite par les lecteurs et les grammairiens l'en écartent, toutes, et la couche de la grammaire davantage que les autres. C'est le témoignage chiffré du chapitre 3 de NABA, la controverse : le procès des grammairiens.
Le rasm, sans voyelles ni aucun signe ajouté, se comporte exactement comme une langue vivante. Ces lois ne viennent d'aucune règle écrite : elles viennent de l'usage. La grammaire arabe, elle, a été codifiée après le texte. C'est l'un des arguments du dossier sur la grammaire ajoutée : le texte écrit précède les règles qu'on lui a appliquées.
Le chiffre des hapax rejoint celui de l'article Les hapax du Coran. L'écart léger vient de la normalisation : ici, le rasm seul, sans la hamza.
Le document complet, à télécharger. Toute la mesure, les tableaux des huit transmissions couche par couche, les graphiques et la méthode, pour la vérifier, la refaire ou la présenter.
La méthode, pour la refaire
- Texte : transmission de Hafs, édition de Médine, 6 236 versets.
- Normalisation : voyelles, signes d'arrêt et hamza retirés ; ة lu ه ; les formes de l'alif unifiées. Un mot = une suite de lettres entre deux espaces.
- Pente de Zipf : régression linéaire de log(fréquence) sur log(rang), rangs 1 à 1 000.
- Heaps : nombre de mots différents relevé tous les 500 mots, puis pente en échelle logarithmique.
- Témoin : toutes les lettres et les espaces du texte normalisé, mélangés au hasard (graine fixe), puis mesurés de la même façon.
Sources. Comptages effectués le 23 octobre 2026 sur l'édition imprimée de Hafs (Complexe du Roi Fahd). G. K. Zipf, Human Behavior and the Principle of Least Effort, 1949 ; G. A. Miller, « Some effects of intermittent silence », 1957 ; H. S. Heaps, Information Retrieval, 1978.